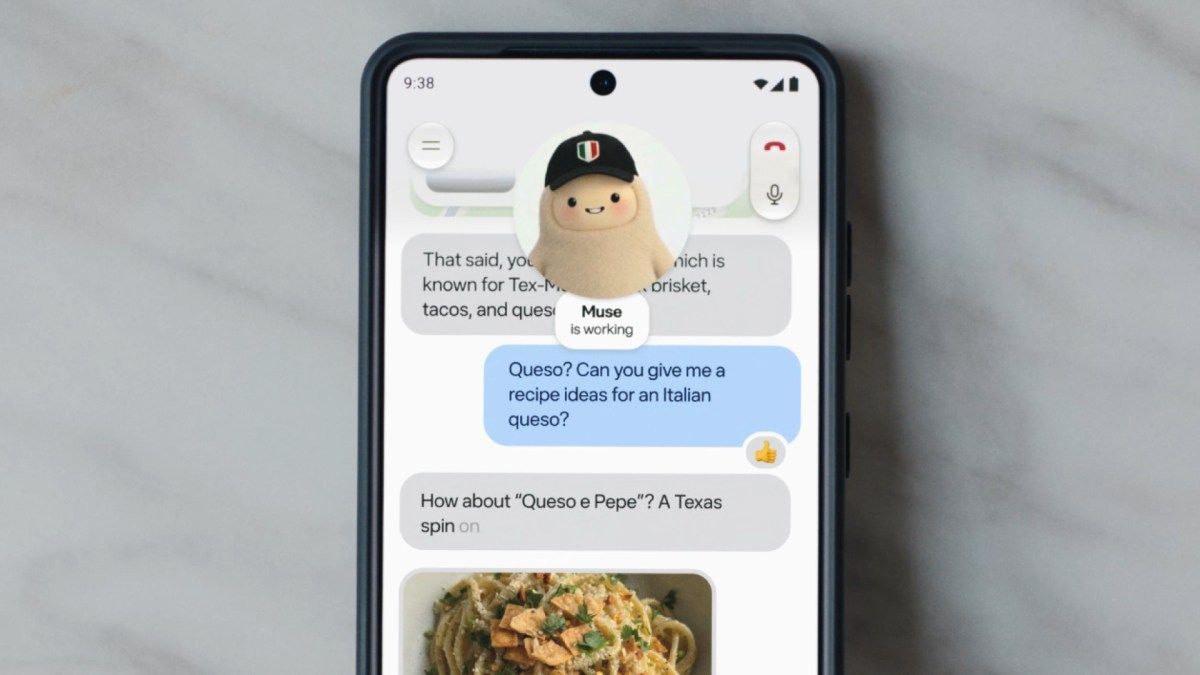
同じ「AIモデル」でも、作り手の狙いによって得意なことはまったく違う。テックメディアのTechloyは11月16日、どちらも11月9日に発表されたAnthropicの「Claude Fable 5.2」と、Metaの「Muse Ember」を比較する記事を公開した。Fable 5.2はAnthropicの一般向け最上位モデルで、長時間かかる複雑な仕事を任せることを想定している。一方のMuse Emberは、MetaのAIエージェント「Muse」の系列で最も軽く安いモデルで、エージェントが何百回も繰り返す細かい作業を大量にこなすために作られた。
難しい問題はFable 5.2が大差
プログラミングの力では、Fable 5.2が大きく上回る。Anthropicによると、Fable 5.2は実践的なコーディング評価「FrontierCode 2.0」で49.1%、「FrontierSWE v2」で69.9%を記録した。Muse EmberはFrontierCode 2.0で27.2だった。Metaは、Emberはエージェントが細かく切り出したコーディング作業向けで、複雑な問題は上位の「Muse Wonder」と組み合わせて使うよう説明している。
専門家レベルの知識を問う難関テスト「Humanity's Last Exam(HLE-Diamond)」でも、Fable 5.2の80.2%に対しEmberは25.1%。理科・数学の推論を測る「CritPt v2」の難問でも76.5%対39.0%と差が開いた。Anthropicは、Fable 5.2が1,000体のサブエージェント(手分けして働く小さなAI)を取りまとめて大きな仕事を進められるとしている。
速さと料金はEmberが圧倒
一方、速さと料金ではEmberが大きく勝つ。第三者評価のArtificial Analysisの測定では、出力の速さはEmberが毎秒440トークン、Fable 5.2は毎秒97トークンだった。最初の1語が返ってくるまでの時間も、Emberの4.8秒に対し、最大の推論設定で使ったFable 5.2は約267秒かかった。一度に読み込める量はどちらも100万トークンだが、一度に書き出せる量はFable 5.2の12.8万トークンに対しEmberは51.2万トークンと4倍ある。
料金(100万トークンあたり)は、Fable 5.2が入力8ドル・出力40ドル、Emberは入力0.10ドル・出力0.50ドルで、どちらも80分の1だ。同じ内容を繰り返し読み込む場合の割引料金も、Fable 5.2の0.20ドルに対しEmberは0.004ドルとなっている。Fable 5.2の作例は、当サイトの97KBの海中世界の記事でも紹介している。
| 項目 | Claude Fable 5.2 | Muse Ember |
|---|---|---|
| FrontierCode 2.0 | 49.1% | 27.2 |
| HLE-Diamond | 80.2% | 25.1% |
| CritPt v2(難問) | 76.5% | 39.0% |
| 出力速度(毎秒) | 97トークン | 440トークン |
| 最初の応答まで | 約267秒(最大推論設定) | 4.8秒 |
| 最大出力 | 12.8万トークン | 51.2万トークン |
| 料金(入力/出力、100万トークンあたり) | 8ドル/40ドル | 0.10ドル/0.50ドル |
速度はArtificial Analysisの測定。ベンチマークは各社公表値をTechloyがまとめたもの(FrontierCode 2.0のEmberは別集計の数値)。出典: Techloy(2026年11月16日)をもとにKEN TECH TIMES編集部作成