ローカルLLM 公式
Googleのオープンな埋め込みモデル「EmbeddingGemma 2」、技術報告書を公開 文字・画像・音声・動画を1つの“意味の地図”に
カテゴリ: ローカルLLM
執筆: KEN TECH TIMES 編集部
約4分で読めます
この記事を聴く
音声は公式マスコット「ロボ」の声で、記事の要点を読み上げています。文字で読みたい方は、このまま下の本文をお読みください。
ONにすると要点・用語解説・よくある質問だけを表示します。よくある質問へ
要点Googleは11月17日、オープンモデル「EmbeddingGemma 2」の技術報告書を公開した。文字だけを扱っていた前の版から、画像・音声・動画とその組み合わせまで1つの“意味の空間”に変換できるようになり、モデル本体もよりコンパクトにしたという。
 画像: Google(公式ブログ)
Googleは2026年11月17日、公式ブログ「The Keyword」で、オープンな埋め込みモデル「EmbeddingGemma 2」の技術報告書(開発の詳しい中身をまとめた文書)を公開したと発表した。EmbeddingGemma 2は、Googleのオープンモデル「Gemma」シリーズのうち、文章や画像の“意味”を数値に置き換える役目に特化したモデルで、誰でもダウンロードして自分のパソコンやサーバーで動かせる。
文字だけから、画像・音声・動画へ
前の版のEmbeddingGemmaは文字(テキスト)だけを扱うモデルだった。発表によると、EmbeddingGemma 2はこれを広げ、文字・画像・音声・動画、さらにそれらを組み合わせたものを、生まれつき(後付けの部品なしで)理解できるようになった。どの種類のデータも1つの共通の「埋め込み空間」に置かれるため、たとえば「海辺で犬が走る」という文章と、その様子を写した写真や動画が、同じ場所の近くに並ぶことになる。あわせて、モデルの骨組み(バックボーン)をよりコンパクトにまとめたとしている。
技術報告書では、学習の進め方、評価の方法、実験の結果を詳しく説明している。作り方には、最新のオープンモデル「Gemma 4」と、Googleの埋め込みモデル「Gemini Embedding 2」の技術を土台にした工夫が盛り込まれ、表現力が高く統一された“ベクトル空間”を学べるようにしたという。Googleは仕組みと開発の経緯を5分で解説する動画も用意した。
埋め込みモデルは何に使うのか
埋め込みモデルは、チャットAIのように文章を書くAIではなく、「意味が近いもの同士を見つける」ための道具だ。社内の資料からAIに答えを探させる仕組み(RAG)や、写真の中から言葉で探す検索、似た商品のおすすめなどの裏側で使われている。画像や音声、動画まで1つのモデルでまとめて扱えると、たとえば「会議の録音」と「スライドの画像」と「議事録の文章」を横断して探す、といった使い方がしやすくなる。オープンモデルなので、データを外部のサービスに送らずに手元で処理したい用途にも向く。
当サイトでは、オープンなAIモデルをめぐる動きとしてHugging FaceとOpenRouterのオープンウェイトモデルに関する話題も伝えている。

 ロボとペラの用語解説
「埋め込み(エンベディング)」って?
文章や画像の「意味」を数字の並びに置き換えることだよ。意味が近いものほど数字も近くなるから、似たものを探すのが得意になるんだ。
「オープンモデル」って?
中身のデータが公開されていて、誰でもダウンロードして自分のパソコンなどで動かせるAIのことだよ。
「RAG」って?
AIが答える前に、資料の中から関係のある部分を探してきて、それを参考に答える仕組みだよ。埋め込みモデルが探す役を担当するんだ。
「マルチモーダル」って?
文字だけでなく、画像や音声、動画など、いろいろな種類のデータをまとめて扱えることだよ。
用語辞典でほかの言葉も見る
編集部の考察
EmbeddingGemma 2の意義は、画像や音声、動画まで1つの“意味の地図”に載せられるモデルを、誰でも手元で動かせる形で出した点にあります。これまでは文字用と画像用で別々のモデルを用意し、結果をつなぎ合わせる手間がありましたが、1つのモデルで済めば、社内の資料探しや写真・動画の検索を作るハードルがぐっと下がります。クラウドの有料サービスとして提供される埋め込みモデルと比べると、データを外に出さずに済むオープンモデルは、個人情報や機密資料を扱う会社にとって安心感のある選択肢です。モデル本体を小さくしたことも、高性能なサーバーがない中小企業や個人の開発者にとっては使いやすさにつながります。技術報告書で作り方が公開されたことで、他の研究者が改良版を作ったり、日本語のデータで調整したりする動きも期待できます。今後は、日本語を含む多言語での実力や、パソコンでどのくらい軽快に動くかの検証結果が出てくるかに注目です。
執筆者・運営: KEN TECH TIMES 編集部(KEN TECH TIMES)/記事の誤りのご指摘は訂正方針をご覧ください
本記事はアフィリエイトプログラムによる収益を得ている場合があります
よくある質問
QEmbeddingGemma 2は何ができるのですか?
A文字・画像・音声・動画やそれらの組み合わせを、1つの共通の“意味の空間”に変換できます。似た意味のデータを探す検索やRAGなどに使われます。
QChatGPTのように会話できるのですか?
Aいいえ。埋め込みモデルは文章を書くAIではなく、意味が近いもの同士を見つけるための道具です。
Q前の版と何が違うのですか?
A前の版は文字だけを扱うモデルでしたが、EmbeddingGemma 2は画像・音声・動画にも対応し、モデル本体もよりコンパクトになったとGoogleは説明しています。
Q今回公開されたのは何ですか?
A学習方法、評価の方法、実験結果をまとめた技術報告書と、仕組みを解説する約5分の動画です。
答えはこの記事の本文と出典の範囲で書いています。
この記事について質問する
質問を入力すると、この記事の本文・よくある質問・用語解説の中から、関係する部分を探してお答えします。記事に書かれていない内容には答えられません。
関連記事
ローカルLLM報道
中国のMoonshot AI、Tencent、Alibabaが、サイバー攻撃に使える能力を意図的に弱めた新しいAIモデルを相次いで公開した。誰でもダウンロードできるオープンなモデルも含まれる。Zhipu AIも最も危険な能力を本人確認の後ろに置く方針で、中国の主要4社が約3週間で同じ方向に動いた。
ローカルLLM公式図解あり
AIモデル共有サイトのHugging Faceは、オープンウェイトのAIモデルを手軽に動かすため、AIの中継サービスOpenRouterと提携した。言語モデルへの依頼は今後OpenRouterの仕組みで80社超の提供元から最適な1社に自動で振り分けられる。各モデルのページでは料金や速さの比較も見られるようになった。
ローカルLLM公式図解あり
NVIDIAは、小型AIコンピューター「DGX Spark」4台をつないで机の上に置ける研究者向けの「DGX Spark HPC Developer Kit」を発表した。合計512GBのメモリーで、最大7,000億パラメータ級のAIモデルを手元で動かせるという。
ローカルLLM報道
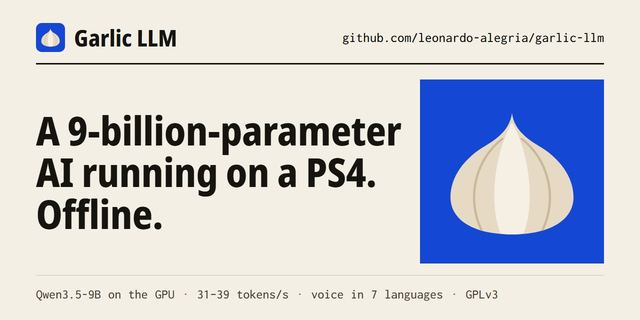
開発者のレオナルド・アレグリア氏が公開したオープンソースのアプリ「Garlic LLM」で、改造したPS4上でAlibabaの90億パラメータのAIモデル「Qwen3.5-9B」がインターネットなしで動いた。文字のやり取りで毎秒31〜39トークン、7か国語の音声会話にも対応する。
ローカルLLM報道図解あり
動画生成AIで知られる米Runwayが、動画モデルをもとにロボットを動かすAI「Praxis-1」の重み(中身のデータ)と実行・追加学習用のコードを、商用利用もできるApache 2.0ライセンスで公開した。パラメーター数は272億で、80GBのGPU1枚で動くという。