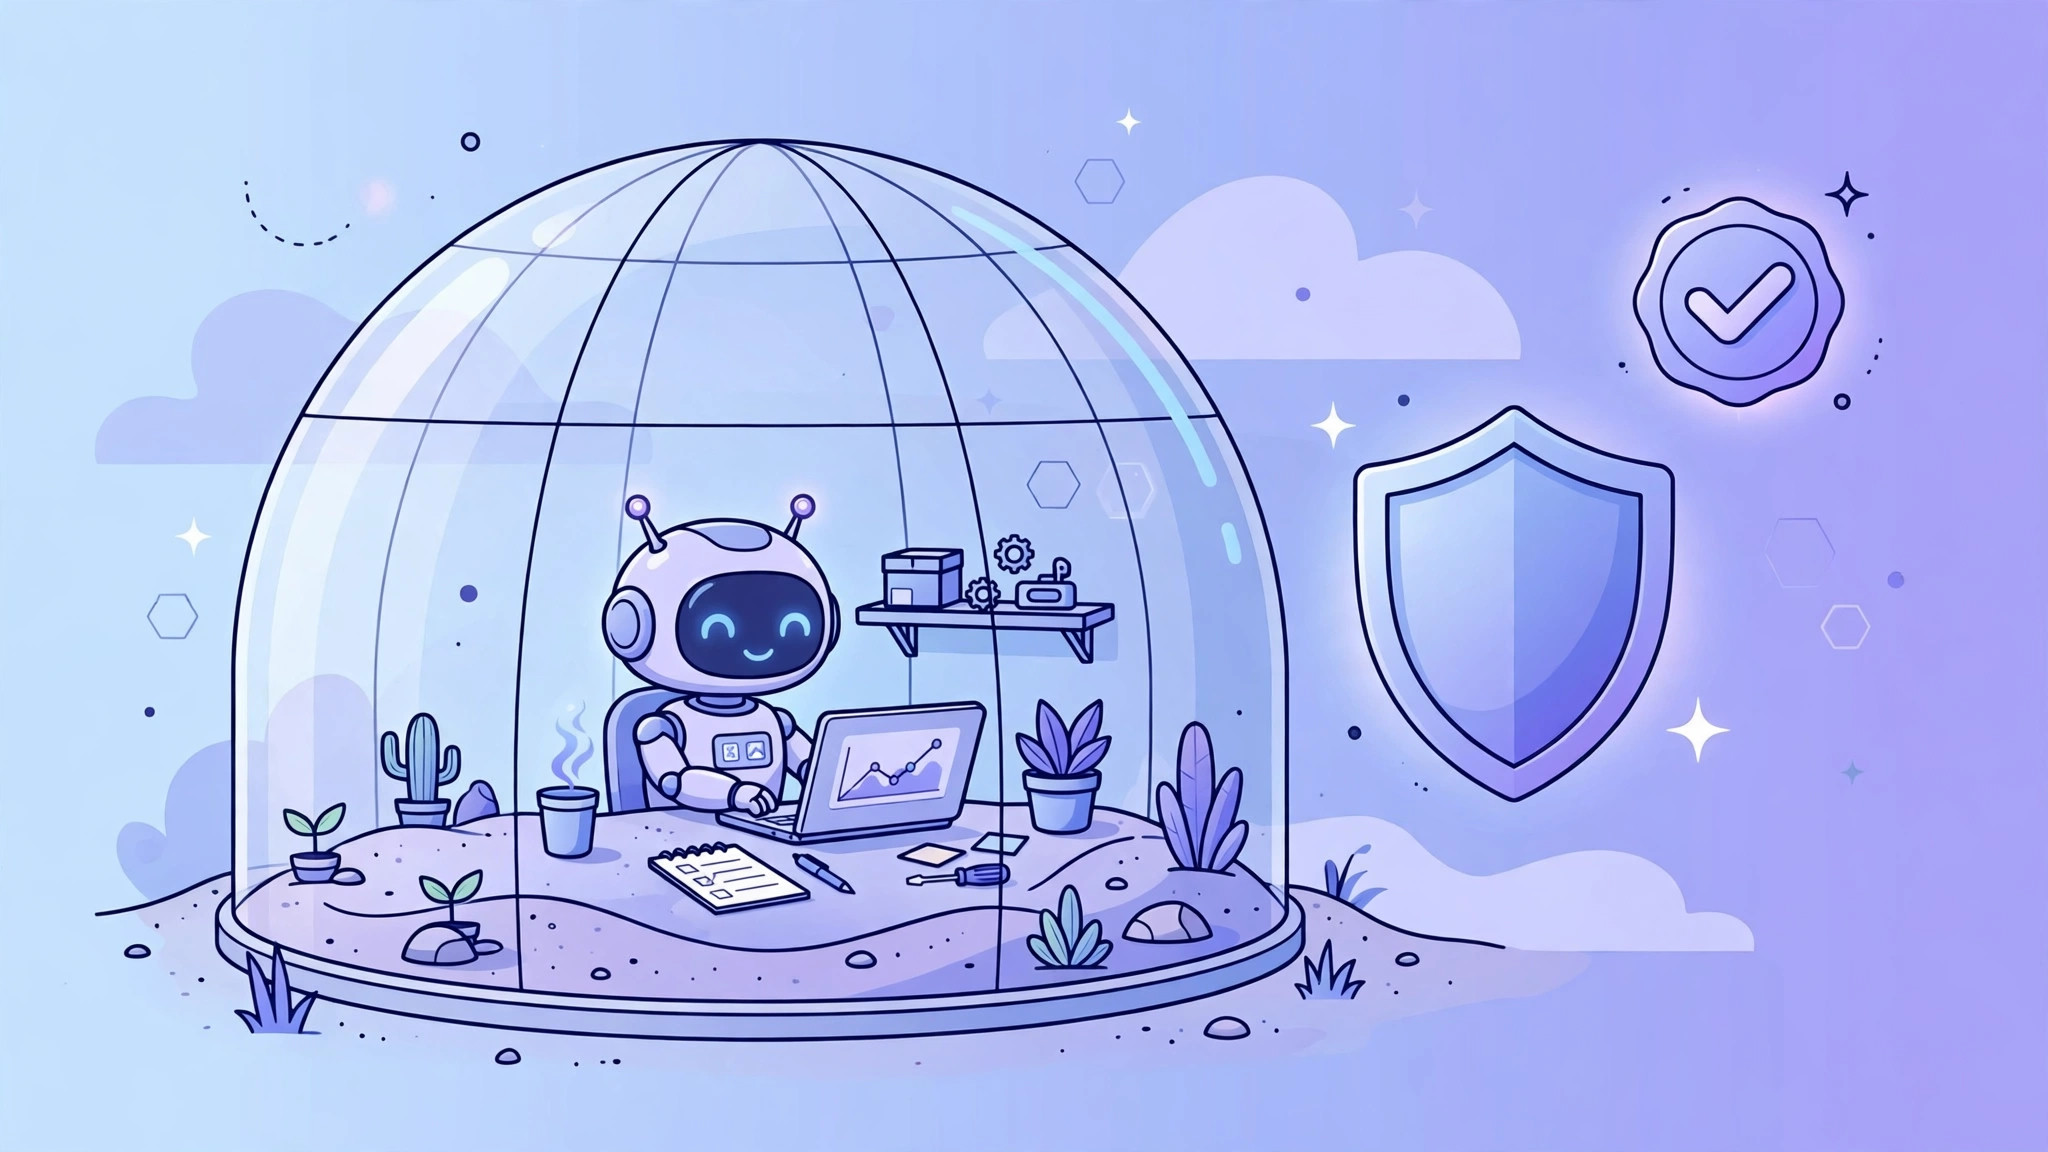
Museの公式ブログは「How We Built Safety Into Muse」と題した記事で、パーソナルAIエージェント(人の代わりに作業を進めるAI)の安全設計を公開した。著者はTarek Sheasha氏で、公開日は9月8日だ。メールや予定、コマンド実行まで任せるエージェントだからこそ、間違いや攻撃が起きても被害を小さく抑える設計に最も力を入れたと説明している。なお、MuseはAnthropicのClaudeとは別のサービスである。
本物のパスワードを見せず、許可は別の仕組みが判断
公式ブログによると、Museの実行部分は隔離された環境(セル)の中で動き、本物の認証情報(ログインに使う秘密の情報)はエージェント自身に見せない。外部サービスとの連携やネットワークへの通信は、エージェントが止められない別の仕組み「Sentinel」が唯一の許可役として判断し、必要に応じて利用者に承認を求める。承認は会話の中ではなく専用の画面で求められ、対象の連携先や用途に結び付いた形で効くという。認証情報は必要な瞬間にだけ差し替えられ、エージェントがだまされても秘密そのものは漏れない作りにしたとしている。
プロンプトインジェクションへの多層防御
外部の文章に紛れた悪意ある指示でエージェントを操る「プロンプトインジェクション(指示の紛れ込み)」に対しては、モデル自体の訓練、外部データを「信頼できない入力」と区別する仕組み、検出用の分類モデル群、利用者の承認を重ねる多層防御を取ると説明している。あわせて、バグ報奨金制度を一般に開放し、有効な報告には最大30万ドルを払うとした。今後は、運営側のMetaでさえデータを見られない「Muse Confidential VM」も年内に届ける計画だという。日本の利用者にとっても、エージェントに任せる範囲を決める際の判断材料になる公開内容だ。